libco源码笔记(1)协程与上下文切换
本文结合微信高性能开源协程库libco,总结了协程相关的问题与解决方案。libco源码注释不多,这里附上我自己的注释版本,建议配合阅读。此外,文中的代码及解释均运行于x86-32位下,64位下的情况略有不同,篇幅有限不再赘述。
回调地狱
在正式开始探讨正题之前,让我们简单回顾一下协程产生的原因。
起初,如下图1(a)中所示,我们的系统中有源源不断的任务(图中task)需要处理。为此我们编写了一个服务端程序。这个程序以单进程方式运行(图中process),并不断获取任务(图中loop)。对于获取到的每个任务,调用处理函数 f() 完成具体处理逻辑。特别地,对于函数 f() 来讲,代码片段 g() 消耗了比较长的时间。但即便如此,系统外部任务的产生间隔还是比 f() 的运行时间长,即整个系统对任务的消费能力高于任务的生产能力,此时我们的服务运转正常。
然而随着业务的发展,我们单位时间内接收的任务越来越多,(a)中的单进程服务模式已经无法及时消费任务。为此,如下图1(b)中所示,我们可以将功能较为独立、资源消耗较大的 g() 部分抽离为单独的进程。原进程使用异步远程调用方式 call_g() 调用g(),并注册回调函数 g_callback() 处理 g() 的返回。在编码时,我们需要将原有顺序的编程方式改为调用部分加回调部分的编程方式。
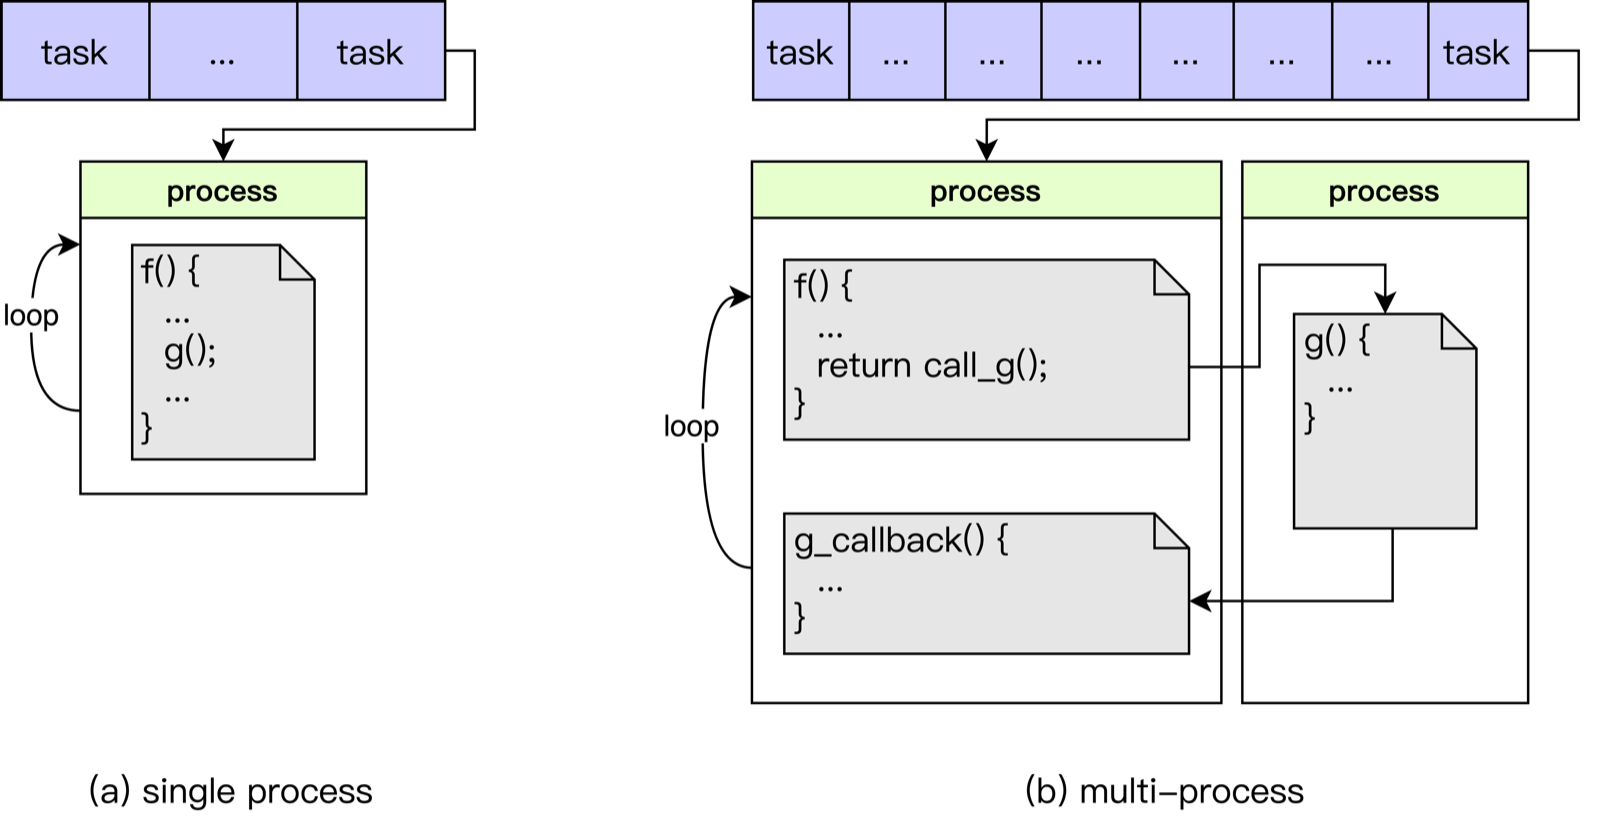 图1
虽然异步的编程方式提高了系统的吞吐量,降低了耦合度,但如下图所示,完整的顺序执行代码片段被分隔成了若干代码片段。在代码相对复杂,需要远程调用较多的时候,代码的可维护性急剧下降,我们称这种现象为回调地狱(callback hell)。
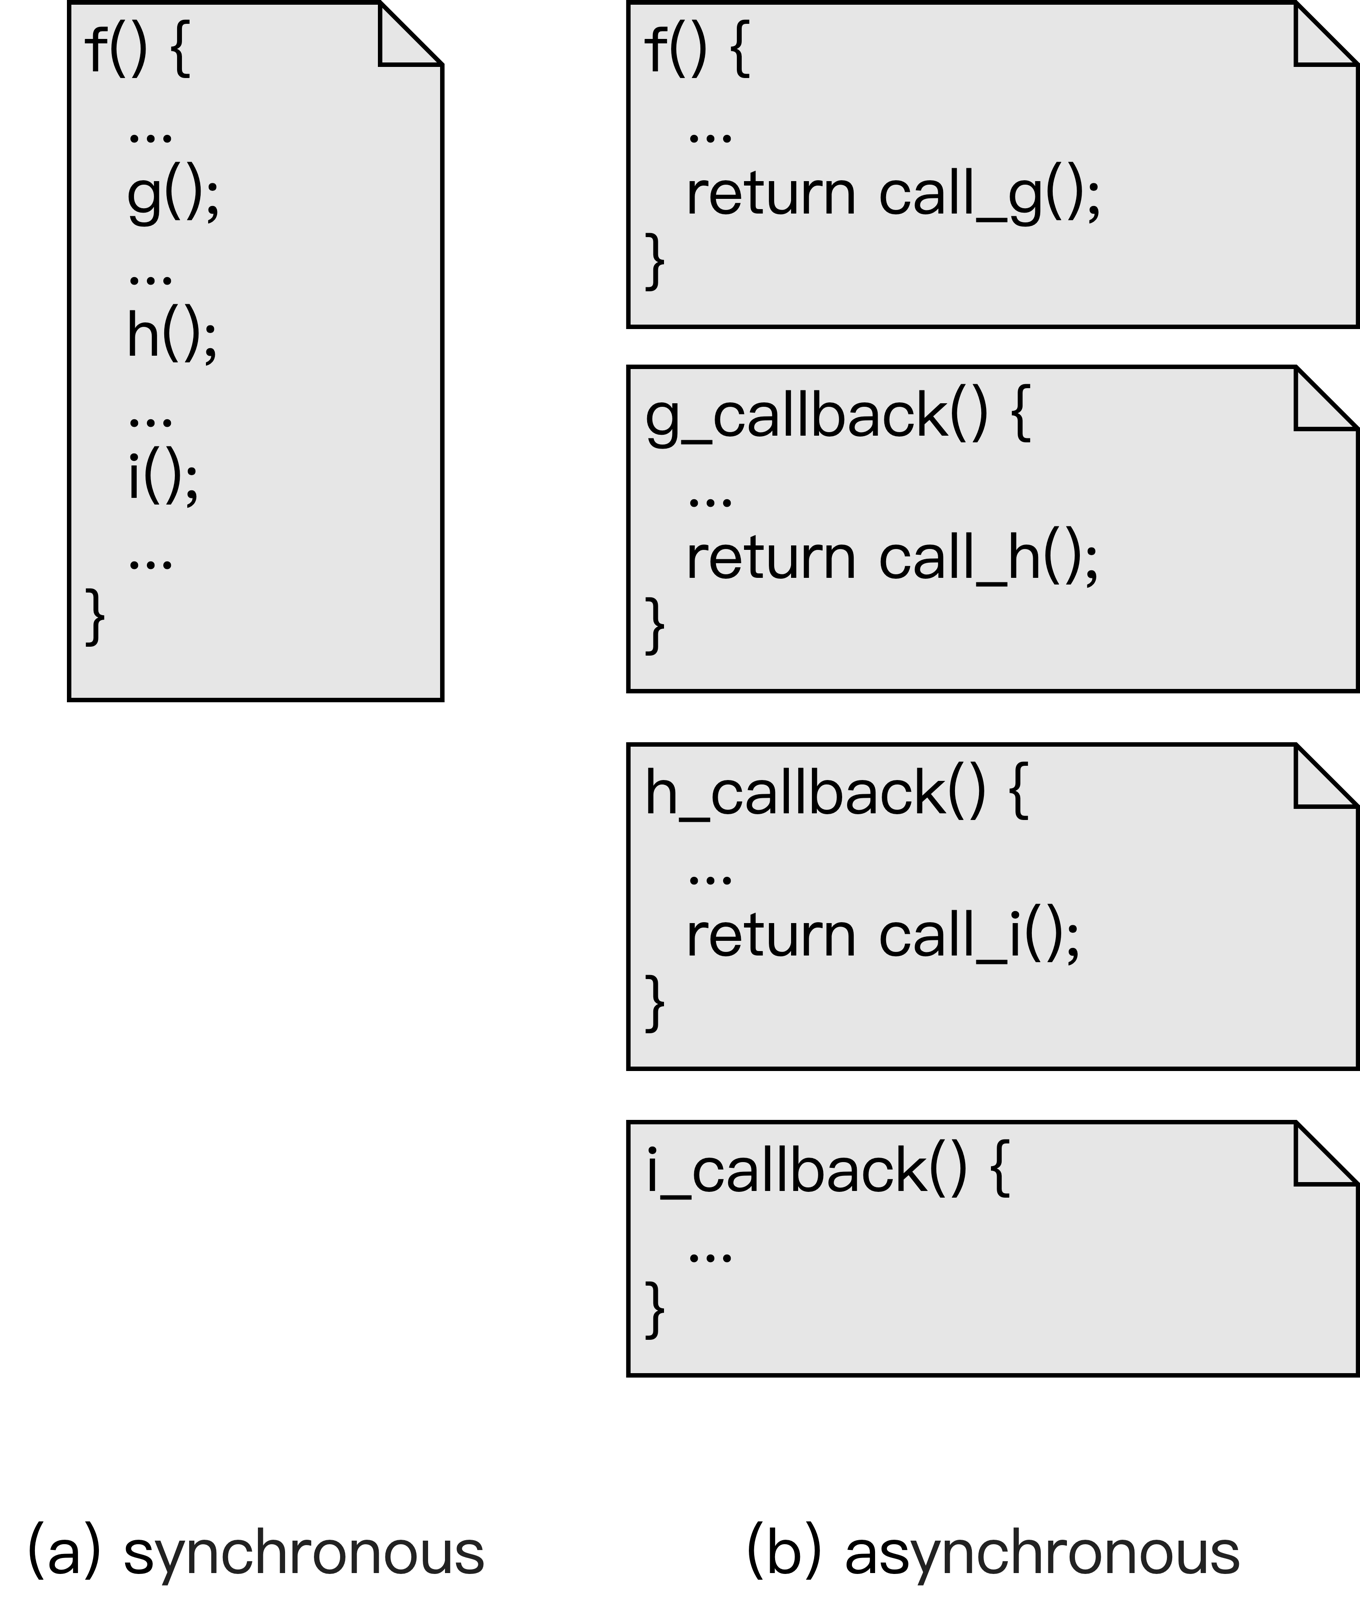 图2. 同步与异步编程下的代码片段
何为协程
那么如何解决回调地狱,在保持异步执行的情况下,将支离破碎的代码段恢复成我们所熟悉的顺序执行呢?我们知道C/C++的程序执行时,运行现场的几乎全部信息都是通过栈帧(stack frame)和寄存器保存的,如果我们在远程调用阻塞时,人为地将程序执行时的上下文保存,让出CPU,并在远程调用返回后加载上下文,就可以在一个函数栈中完成异步过程。我们称这种机制为协程(coroutine)。与熟悉的进程/线程切换类似,协程是用户自发的上下文切换和管理机制,所以也常被称为“用户态线程”。
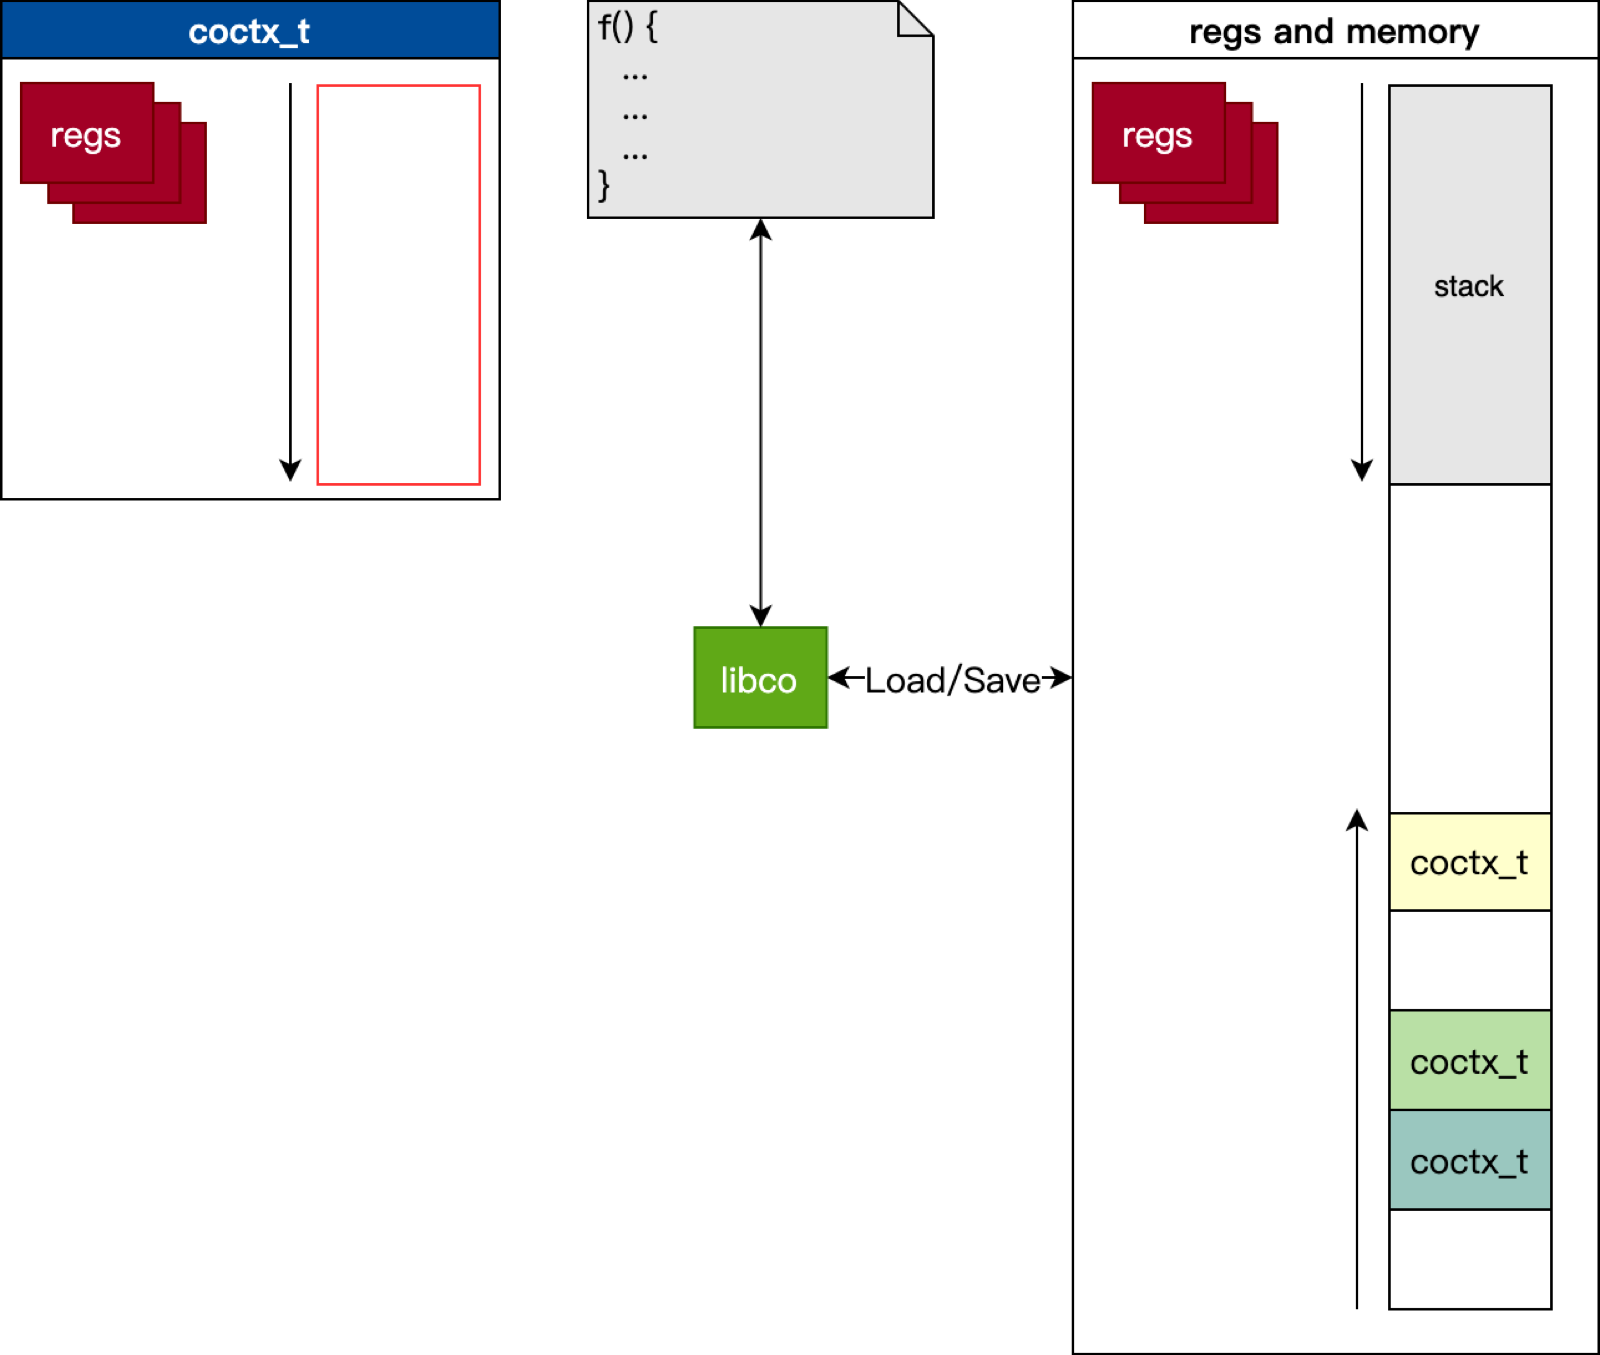 图3. 协程库的职责
协程的上下文与切换
那么需要我们手动保存和加载的运行时“上下文”都包含哪些内容呢?以下面的 main 函数调用 sum 函数为例,
int sum(int x, int y) {
  int z = x + y;
  return z;
}
int main() {
  int a = 1;
  int b = 10;
  int c = sum(a, b);
  return 0;
}
在使用 g++ -m32 -S sum.cpp 编译后,对应的汇编代码如下,
_Z3sumii:
pushl   %ebp
movl    %esp, %ebp
subl    $16, %esp         ;make space for stack
movl    12(%ebp), %eax    ;%eax = y
movl    8(%ebp), %edx     ;%edx = x
addl    %edx, %eax        ;%eax = %eax + %edx
movl    %eax, -4(%ebp)    ;z = %eax
movl    -4(%ebp), %eax    ;%eax = z
leave                     ;%esp = %ebp; pop %ebp
ret                       ;pop %eip; jump(%eip)

main:
pushl   %ebp
movl    %esp, %ebp
subl    $24, %esp         ;make space for stack
movl    $1, -4(%ebp)      ;int a = 1;
movl    $10, -8(%ebp)     ;int b = 10;
movl    -8(%ebp), %eax
movl    %eax, 4(%esp)     ;y = b;
movl    -4(%ebp), %eax
movl    %eax, (%esp)      ;x = a;
call    _Z3sumii          ;push(eip); jump(sum);
movl    %eax, -12(%ebp)
movl    $0, %eax          ;return 0;
如下图所示,代码主要发生在黄色与绿色部分所示的两个函数的栈帧上。ebp基指针寄存器与esp栈指针寄存器标识了栈底与栈顶位置。
$L14$首先将当前ebp压栈,此时由于main函数为进程启动后执行的函数,ebp此时为0。
$L15$设定main函数的ebp位置。
$L16$将esp地址向下移动16,为局部变量与调用sum的形参开辟足够的空间。
$L17-L22$为变量a,b以及sum的形参x,y赋值。
$L23$执行call指令,将当前指令寄存器eip压栈,跳转至sum执行(eip指向sum第一条指令)。
$L2$将当前ebp,即图中ebp_main压栈。
$L3$设定sum函数的ebp位置,指向当前esp。
$L4$开辟栈空间。
$L5, L6$使用ebp_sum + 8, ebp_sum + 12 获得参数x, y的值。
$L7-L9$完成加法运算,并将结果填充到eax。
$L10$调用leave指令,回收esp至ebp位置,并将ebp_main出栈并赋值给ebp。
$L11$调用ret指令,将调用sum前的指令地址eip出栈赋值给eip,至此图中黄色部分main函数的栈得以恢复。
$L24$行将sum的运算结果eax赋值给c。
$L25$行将返回值0赋值给eax,完成整个过程。
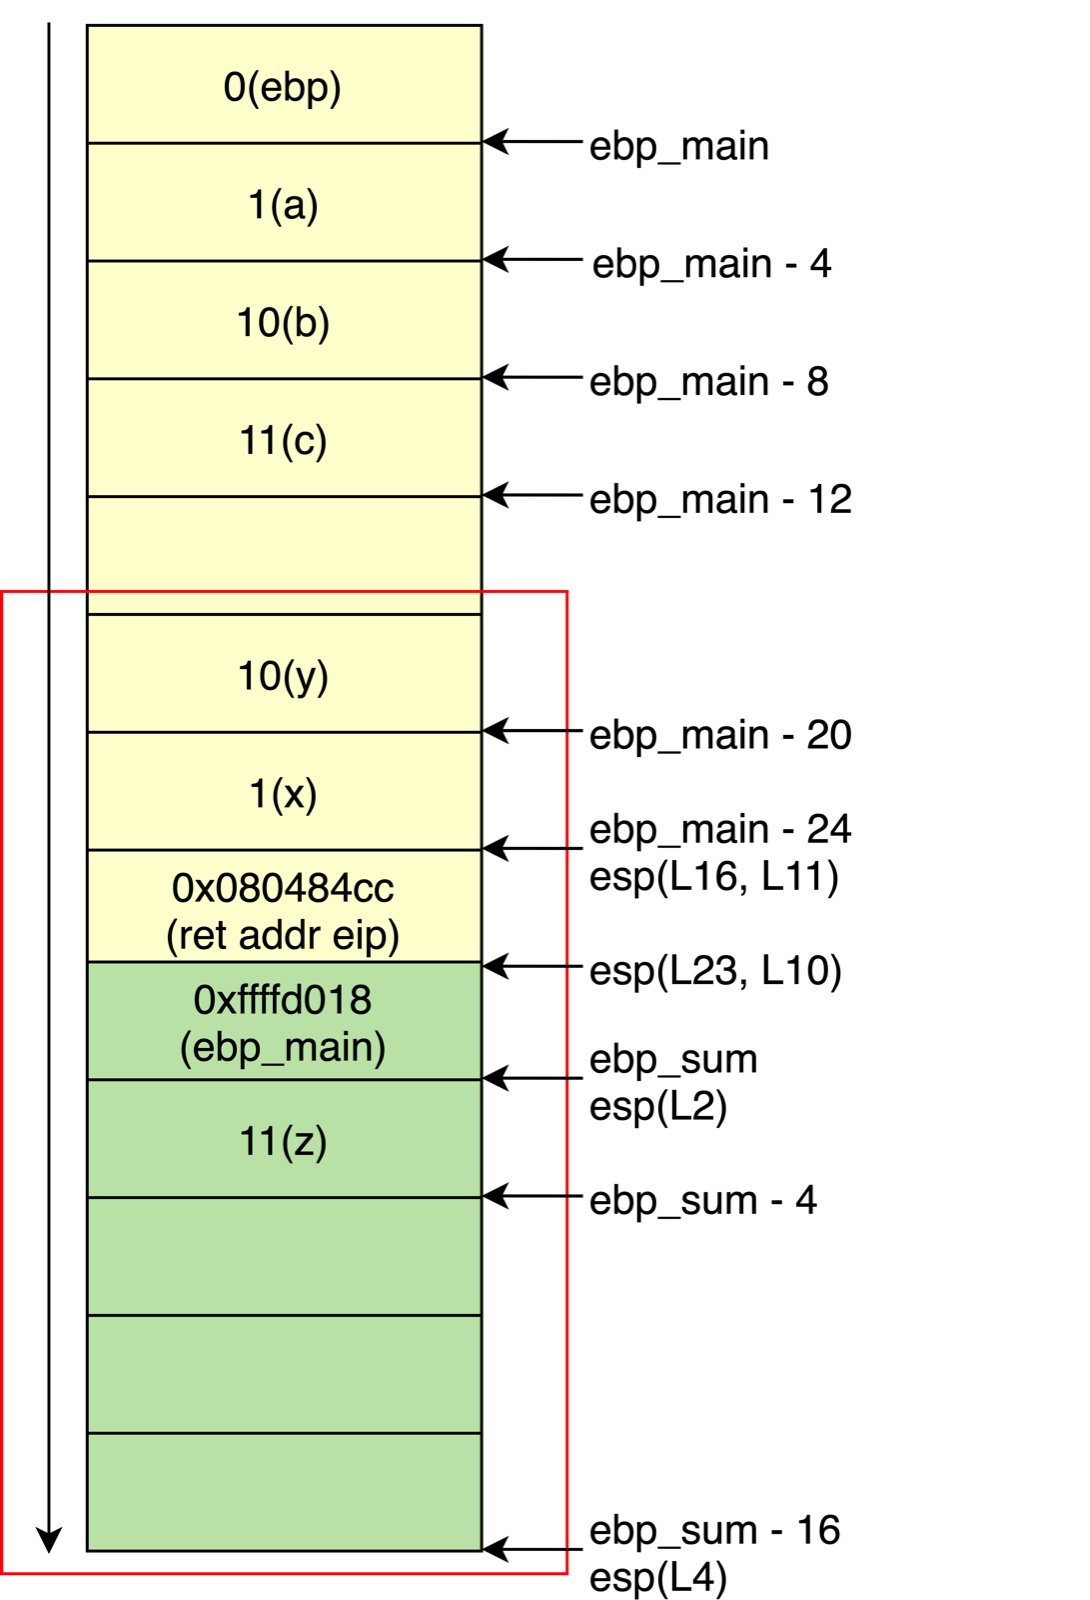 图4. sum.cpp函数栈
通过上面的分析我们不难发现,对于运行时的函数来讲,参数、返回值地址、函数栈、寄存器四个部分组成了运行时的全部信息,通过这些信息我们可以恢复任意函数的执行现场,我们称之为协程的上下文(context)。
coctx_t上下文信息
在libco中,使用如下定义的结构体coctx_t描述协程上下文,其中ss_sp与ss_size保存了参数、返回值地址、函数栈三部分内容,即图4中的红框部分,regs保存了32位/64位下的寄存器。
struct coctx_t
{
#if defined(__i386__)
  void *regs[ 8 ];    //详见coctx.cpp
#else
  void *regs[ 14 ];   //详见coctx.cpp, R10, R11为callee saved register, 由被调用函数保存
#endif
  size_t ss_size;     //协程栈剩余大小
  char *ss_sp;        //协程栈栈底地址
};
co_make上下文初始化
在libco中,使用如下的coctx_make在初次调用(co_resume)时,为协程上下文进行初始的内容填充工作,
/*
 * @param
 * ctx  :指向上下文结构体
 * pfn  :指向调用函数
 * s    :参数
 * s1   :参数
 */
int coctx_make(coctx_t* ctx, coctx_pfn_t pfn, const void* s, const void* s1) {
  // make room for coctx_param
  char* sp = ctx->ss_sp + ctx->ss_size - sizeof(coctx_param_t); //ss_sp内存为堆内存,将sp移动到高地址
  sp = (char*)((unsigned long)sp & -16L);                       //i386要求栈起始地址按16字节对齐

  coctx_param_t* param = (coctx_param_t*)sp;
  void** ret_addr = (void**)(sp - sizeof(void*) * 2);           //返回值地址
  *ret_addr = (void*)pfn;
  param->s1 = s;
  param->s2 = s1;

  memset(ctx->regs, 0, sizeof(ctx->regs));

  ctx->regs[kESP] = (char*)(sp) - sizeof(void*) * 2;
  return 0;
}
经过co_make填充后的协程栈如下图5所示。其中与我们上文中提到的函数调用栈不同的是,在参数与返回值地址之前,空出了4字节(图中NULL),这是为之后的上下文切换做好准备。
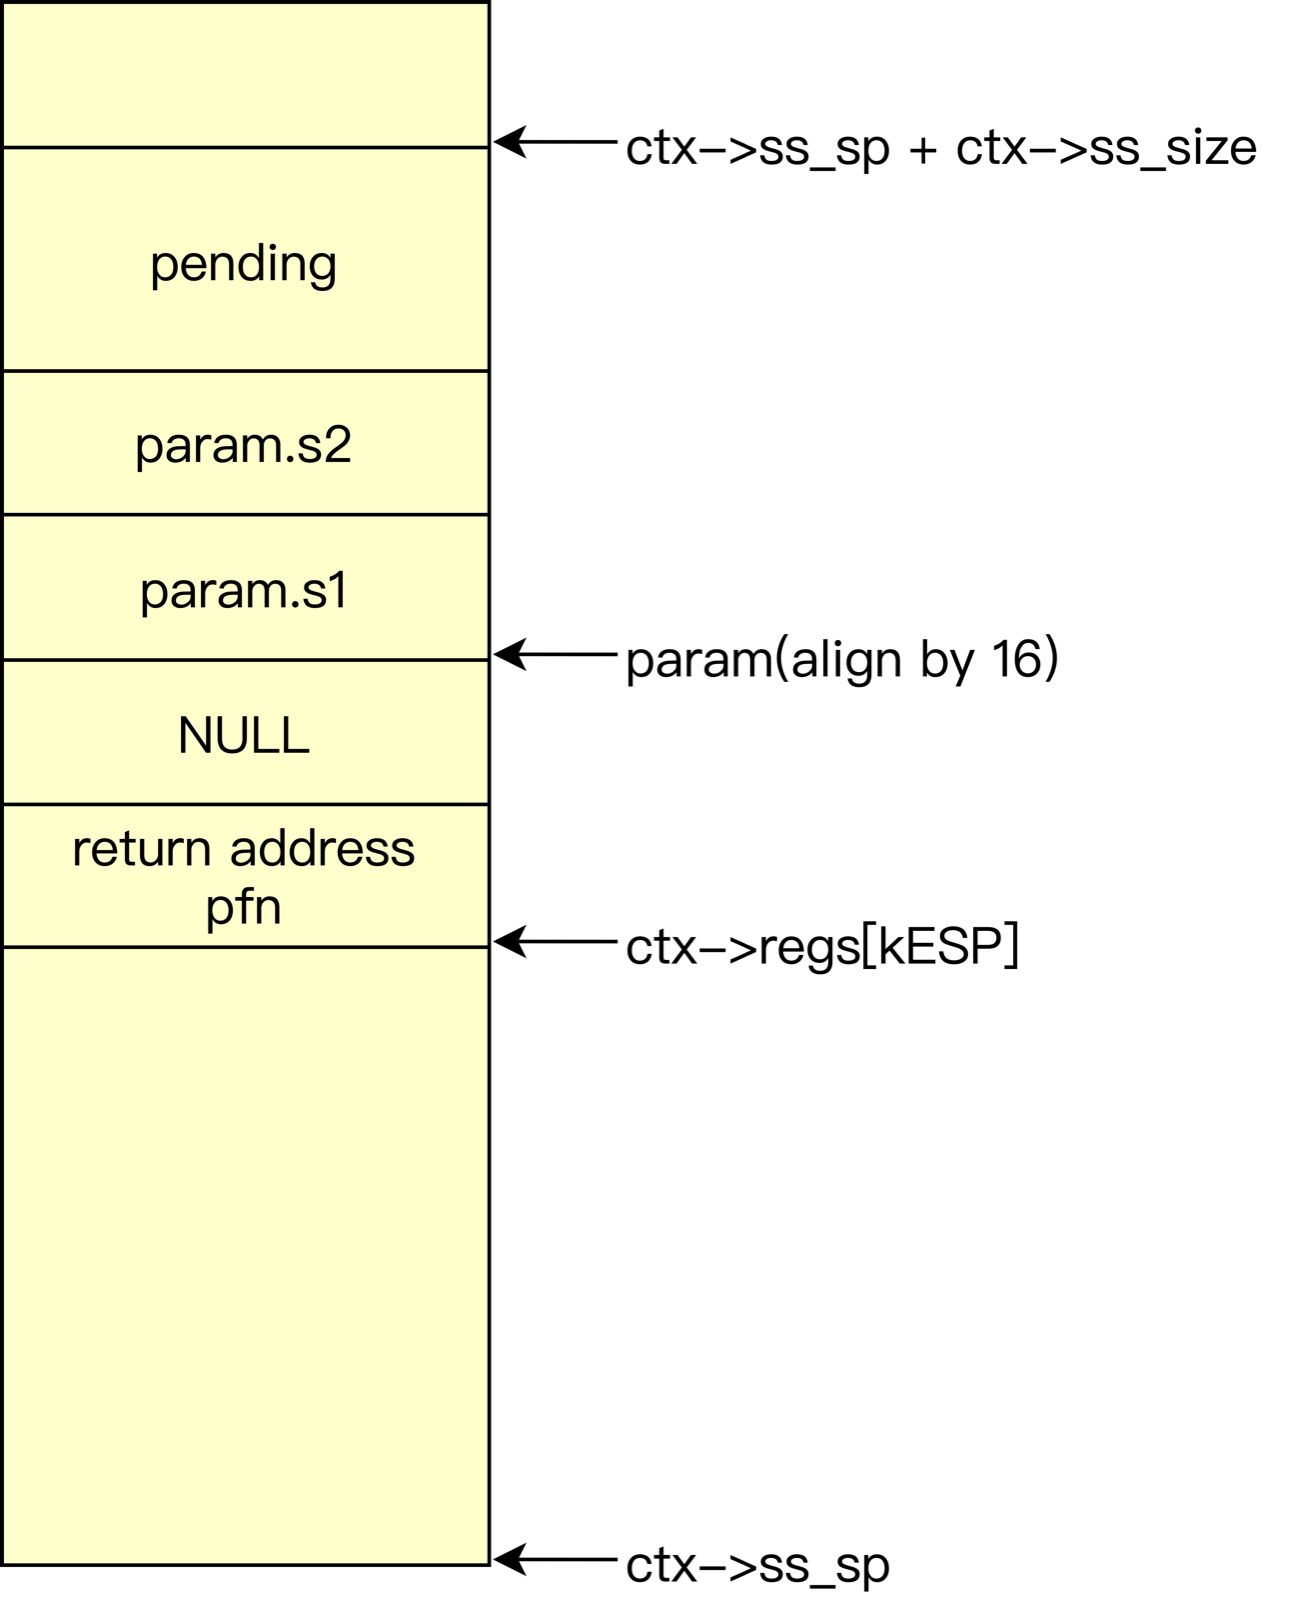 图5. co_make初始化协程栈
coctx_swap上下文切换
extern "C"
{
  extern void coctx_swap( coctx_t *,coctx_t* ) asm("coctx_swap");
};
libco通过coctx_swap函数实现协程的上下文切换,其接收两个coctx_t *作为参数,第一个用于保存当前协程上下文的指针,第二个则是需要换入的上下文指针。
.globl coctx_swap
coctx_swap:
    movl 4(%esp), %eax              ;eax = *(esp+4) 取第一个参数coctx_t
    movl %esp, 28(%eax)             ;coctx_t.regs[7] = esp
    movl %ebp, 24(%eax)             ;coctx_t.regs[6] = ebp
    movl %esi, 20(%eax)             ;coctx_t.regs[5] = esi
    movl %edi, 16(%eax)             ;coctx_t.regs[4] = edi
    movl %edx, 12(%eax)             ;coctx_t.regs[3] = edx
    movl %ecx, 8(%eax)              ;coctx_t.regs[2] = ecx
    movl %ebx, 4(%eax)              ;coctx_t.regs[1] = ebx

    movl 8(%esp), %eax              ;eax = *(esp+8) 取第二个参数coctx_t
    movl 4(%eax), %ebx              ;ebx = coctx_t.regs[1]
    movl 8(%eax), %ecx              ;ecx = coctx_t.regs[2]
    movl 12(%eax), %edx             ;edx = coctx_t.regs[3]
    movl 16(%eax), %edi             ;edi = coctx_t.regs[4]
    movl 20(%eax), %esi             ;esi = coctx_t.regs[5]
    movl 24(%eax), %ebp             ;ebp = coctx_t.regs[6]
    movl 28(%eax), %esp             ;esp = coctx_t.regs[7]

  ret
以下图作为参照,调用coctx_swap前的栈如绿色部分所示,call指令将返回值地址压栈,
$L3$时esp为图中位置,进入coctx_swap函数。
$L3-L10$将寄存器值保存至第一个参数所指coctx_t内。
$L12-L19$将第二个参数所指coctx_t内的信息读取至寄存器,恢复上下文现场。
$L21$的ret指令将eip,即函数pfn入口出栈,并跳转至pfn执行。至此,黄色的栈构造成为调用pfn之前的栈空间(结合图4红框中黄色部分对比)。之前提到的预留的NULL正是此时为ret指令准备的。
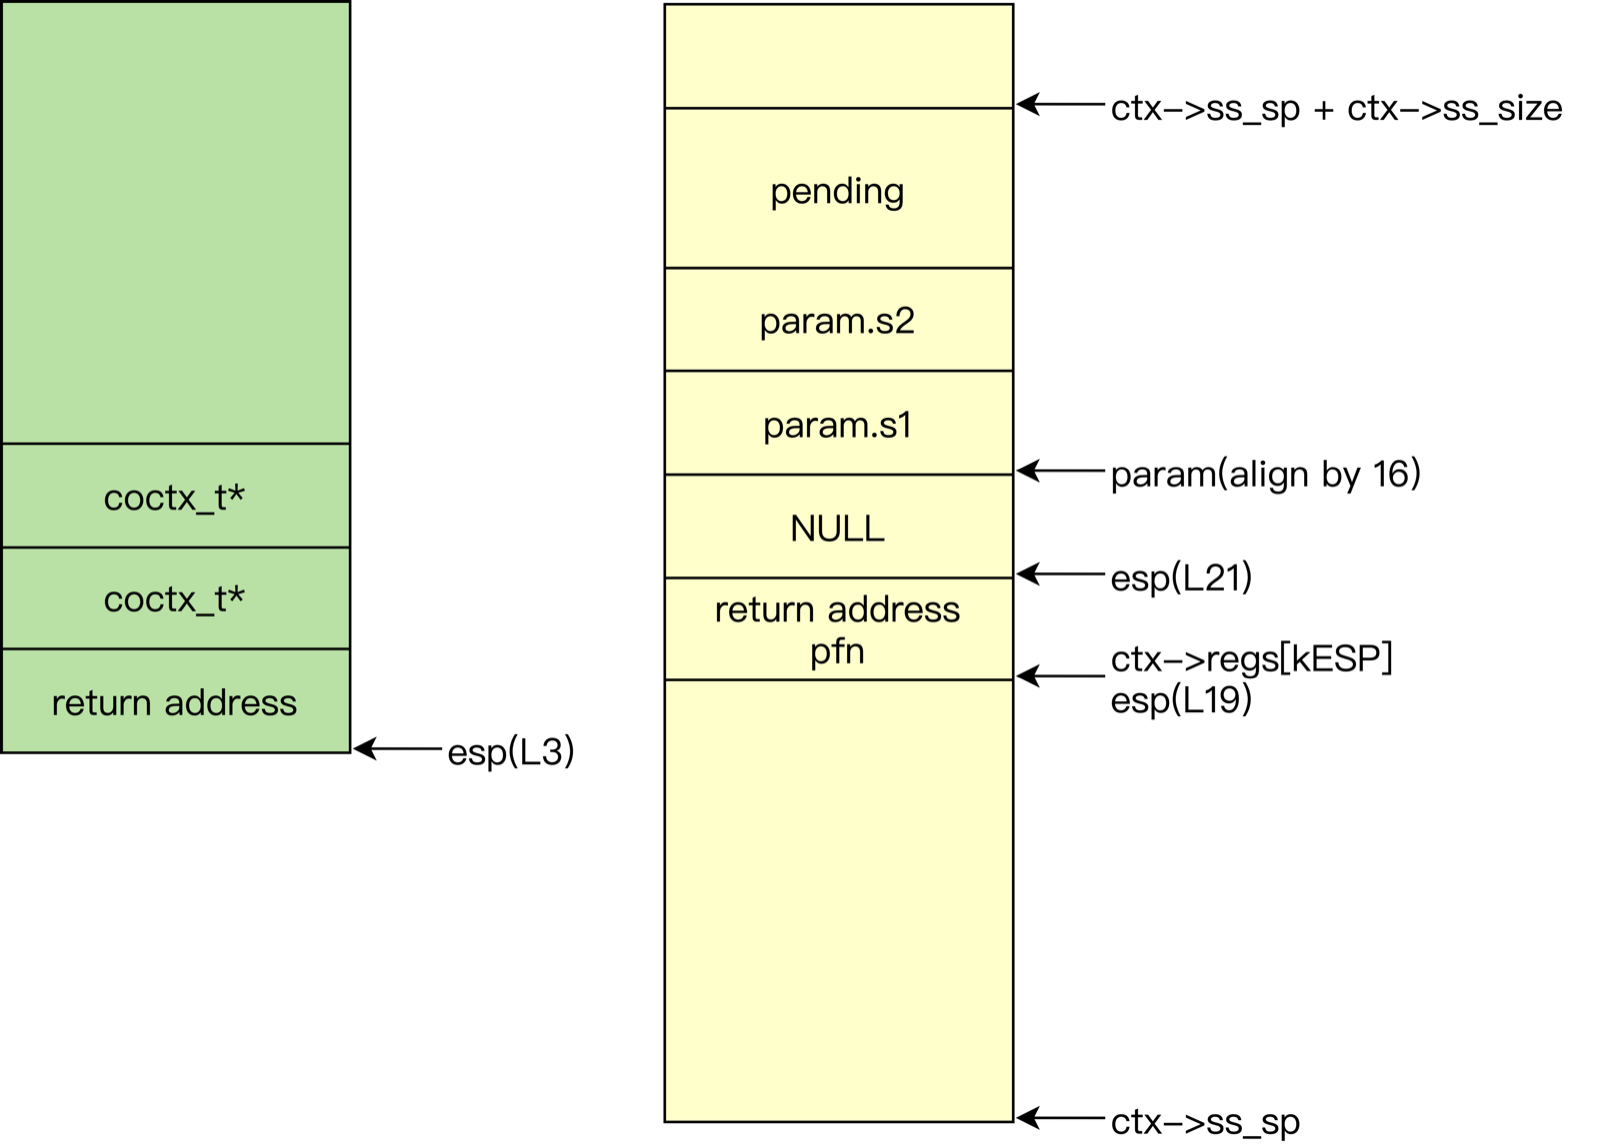 图6. coctx_swap上下文切换
对称与非对称协程
上文我们了解了两个协程是如何进行上下文切换的。对于各个协程的调度方式,如下图所示,主要分为对称协程(symmetric)与非对称协程(asymmetric)两种方式。
对称协程中,各个协程平等运行,调用transfer在各个协程之间自由切换跳转。
而非对称协程以协程调用栈的方式运作,初始时栈内只有主协程。调用resume唤起其他协程入栈,并切换至其上下文运行。在协程运行完毕,或显式调用yield时,协程出栈,切换至上一个协程上下文运行。通常情况下,协程的调用栈不会很深,实际使用中大多是主协程(IO)与逻辑协程相互切换。
在实际应用中,由于对称协程的维护成本更高,很难维护调用链,故而非对称协程使用得更为普遍。本文介绍的libco就是一种非对称协程。
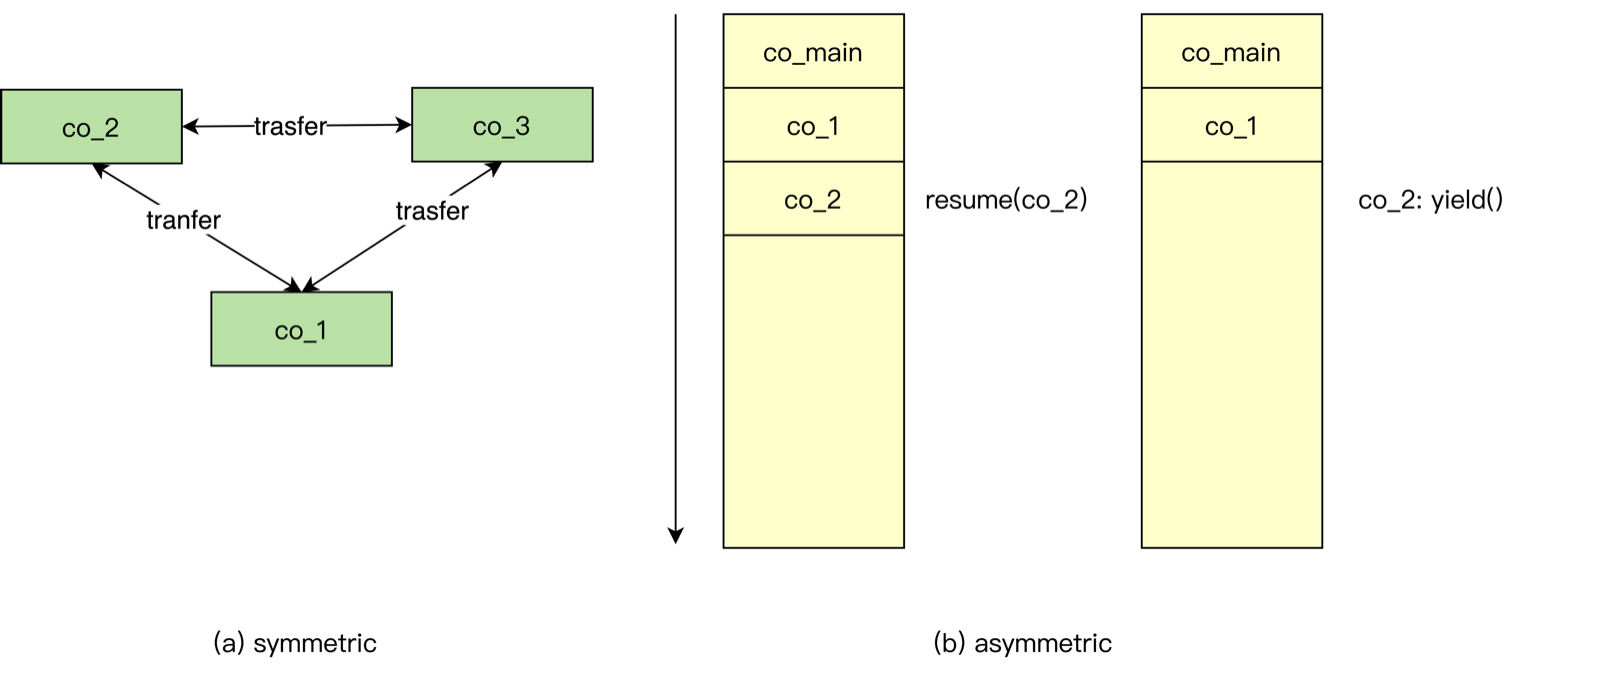 图7. 对称/非对称协程
私有栈与共享栈
阅读上文中coctx_make代码不难发现,libco中协程栈的大小约为ss_size。默认情况下,在libco中调用co_create创建一个新的协程时,会自动在堆区分配ss_size为128K的空间,并将ss_sp指向这里。这种做法使得每个协程拥有独立的栈空间,称为“私有栈”模式,也称为stackful模式。私有栈模式下,协程的上下文切换只需要保存和加载寄存器即可完成,开销很低。但由于每个协程的栈大小固定,会造成栈空间的大量浪费。
与私有栈相对的,libco提供了共享栈模式,也称为stackless模式。共享栈指的是各个协程共用一块固定大小的栈空间(libco中默认128K),在协程切出时,根据当前使用的栈大小用malloc申请一块合适大小的内存,并将共享栈的内容拷贝出去。这种做法更合理地使用了内存空间,但随之带来的是更大的上下文切换开销。
最后
至此,我们结合libco源码介绍了协程中最核心的上下文切换部分。感谢你的阅读。如果你有任何疑问和感想,或发现本文有任何错误,请一定让我知道。